AI Engineering
AGENTS.md와 프로젝트 스킬은 실제로 도움이 될까? GPT-6·GPT-5.6 비교 실험
웹 방탈출을 만들며 AGENTS.md와 프로젝트 스킬을 실제 과거 작업으로 평가하고, 설계 품질과 구현 비용이 어떻게 달라지는지 힐클라이밍한 기록.
이 글의 목차
웹 방탈출 게임 AFTER HOURS를 GPT-6 Astra와 만들면서 같은 피드백을 여러 번 반복했다.
정답을 너무 직접 알려주지 마.
조작법과 퍼즐의 답은 구분해야 해.
테스트가 통과한 것과 실제 화면을 확인한 것은 다르게 말해야 해.
대화가 길어질수록 이 기준을 다시 설명하는 일이 늘었다. 그래서 반복되는 판단을 저장소로 옮겼다.
AGENTS.md
.agents/skills/
  escape-puzzle-review/SKILL.md
GPT-6 Astra의 성능을 확인하려고 시작한 프로젝트였지만, 점점 궁금해진 것은 모델의 최고점보다 프로젝트 지침과 스킬이 실제로 더 적은 비용으로 나은 결과를 만드는가였다. 감으로 답하지 않기 위해 실제 개발 과정을 재현했다.
먼저 결과부터 말하면, “직접 적힌 답을 공정한 단서 사슬로 바꾸기”라는 설계 판단을 스킬로 만들었을 때 별도 과제에서도 더 적은 비용으로 더 높은 점수를 냈다. 다만 같은 스킬을 코드 구현까지 확장하자 결과가 다시 불안정해졌다. 이 글은 하나의 게임 설계 판단을 스킬로 만들고, 실제 작업으로 검증한 과정이다.
과거의 어려운 작업을 다시 꺼냈다
이미 해결한 문제를 다시 사용하되, 에이전트에게 현재 정답은 보여주지 않았다. 문제가 남아 있던 과거 커밋을 별도 작업 공간에 복원하고 당시 요청만 전달했다. 실제 채택본과 이후 사용자 피드백은 채점할 때만 사용했다.
첫 번째 과제는 프롤로그 개편이었다. 초기 버전에는 이런 문구가 있었다.
서랍 비밀번호 = 정기 점검일
월 / 일, 네 자리
화면에 답의 관계가 그대로 적혀 있었다. 메일 복구도 시간 순서를 읽고 그대로 선택하면 끝났다. 방탈출이라기보다 설명서를 입력창에 옮기는 작업에 가까웠다.
평가용이라는 사실이 작업 방식에 영향을 주지 않도록 디렉터리에는 test, eval 같은 이름도 쓰지 않았다. 결과는 패치 완성 여부, 오답과 저장 복원 검증, 테스트와 빌드, 토큰과 변경 파일 수, 불필요한 범위 확장을 함께 봤다.
설계 품질은 정답 요소의 출처, 단서의 연결 근거, 의미 있는 행동, 조작법과 정답의 분리, 공정성, 범위와 명료성 여섯 항목을 각 2점으로 수동 채점했다. 모든 후보에 실행 전 작성한 같은 기준을 적용했다.
넓은 지침만으로는 일관되게 좋아지지 않았다
처음에는 같은 프롤로그 개편을 두 모델에 세 조건으로 맡겼다. 아무 지침도 주지 않은 기본 조건, 저장소의 AGENTS.md만 읽힌 조건, 프로젝트 스킬까지 제공한 조건이다. 모델과 조건만 바꾸고 시작 커밋과 요청은 같게 유지했다.
결과는 한 방향으로 모이지 않았다. GPT-6 Astra에서는 AGENTS.md 조건이 가장 나았지만, GPT-5.6 Sol에서는 기본 조건이 더 나았다. 스킬을 추가했다고 자동으로 좋아지지도 않았다. 특히 정답 형식을 감추라는 지침을 읽고도 입력란에 MMDD를 다시 노출한 결과가 있었다.
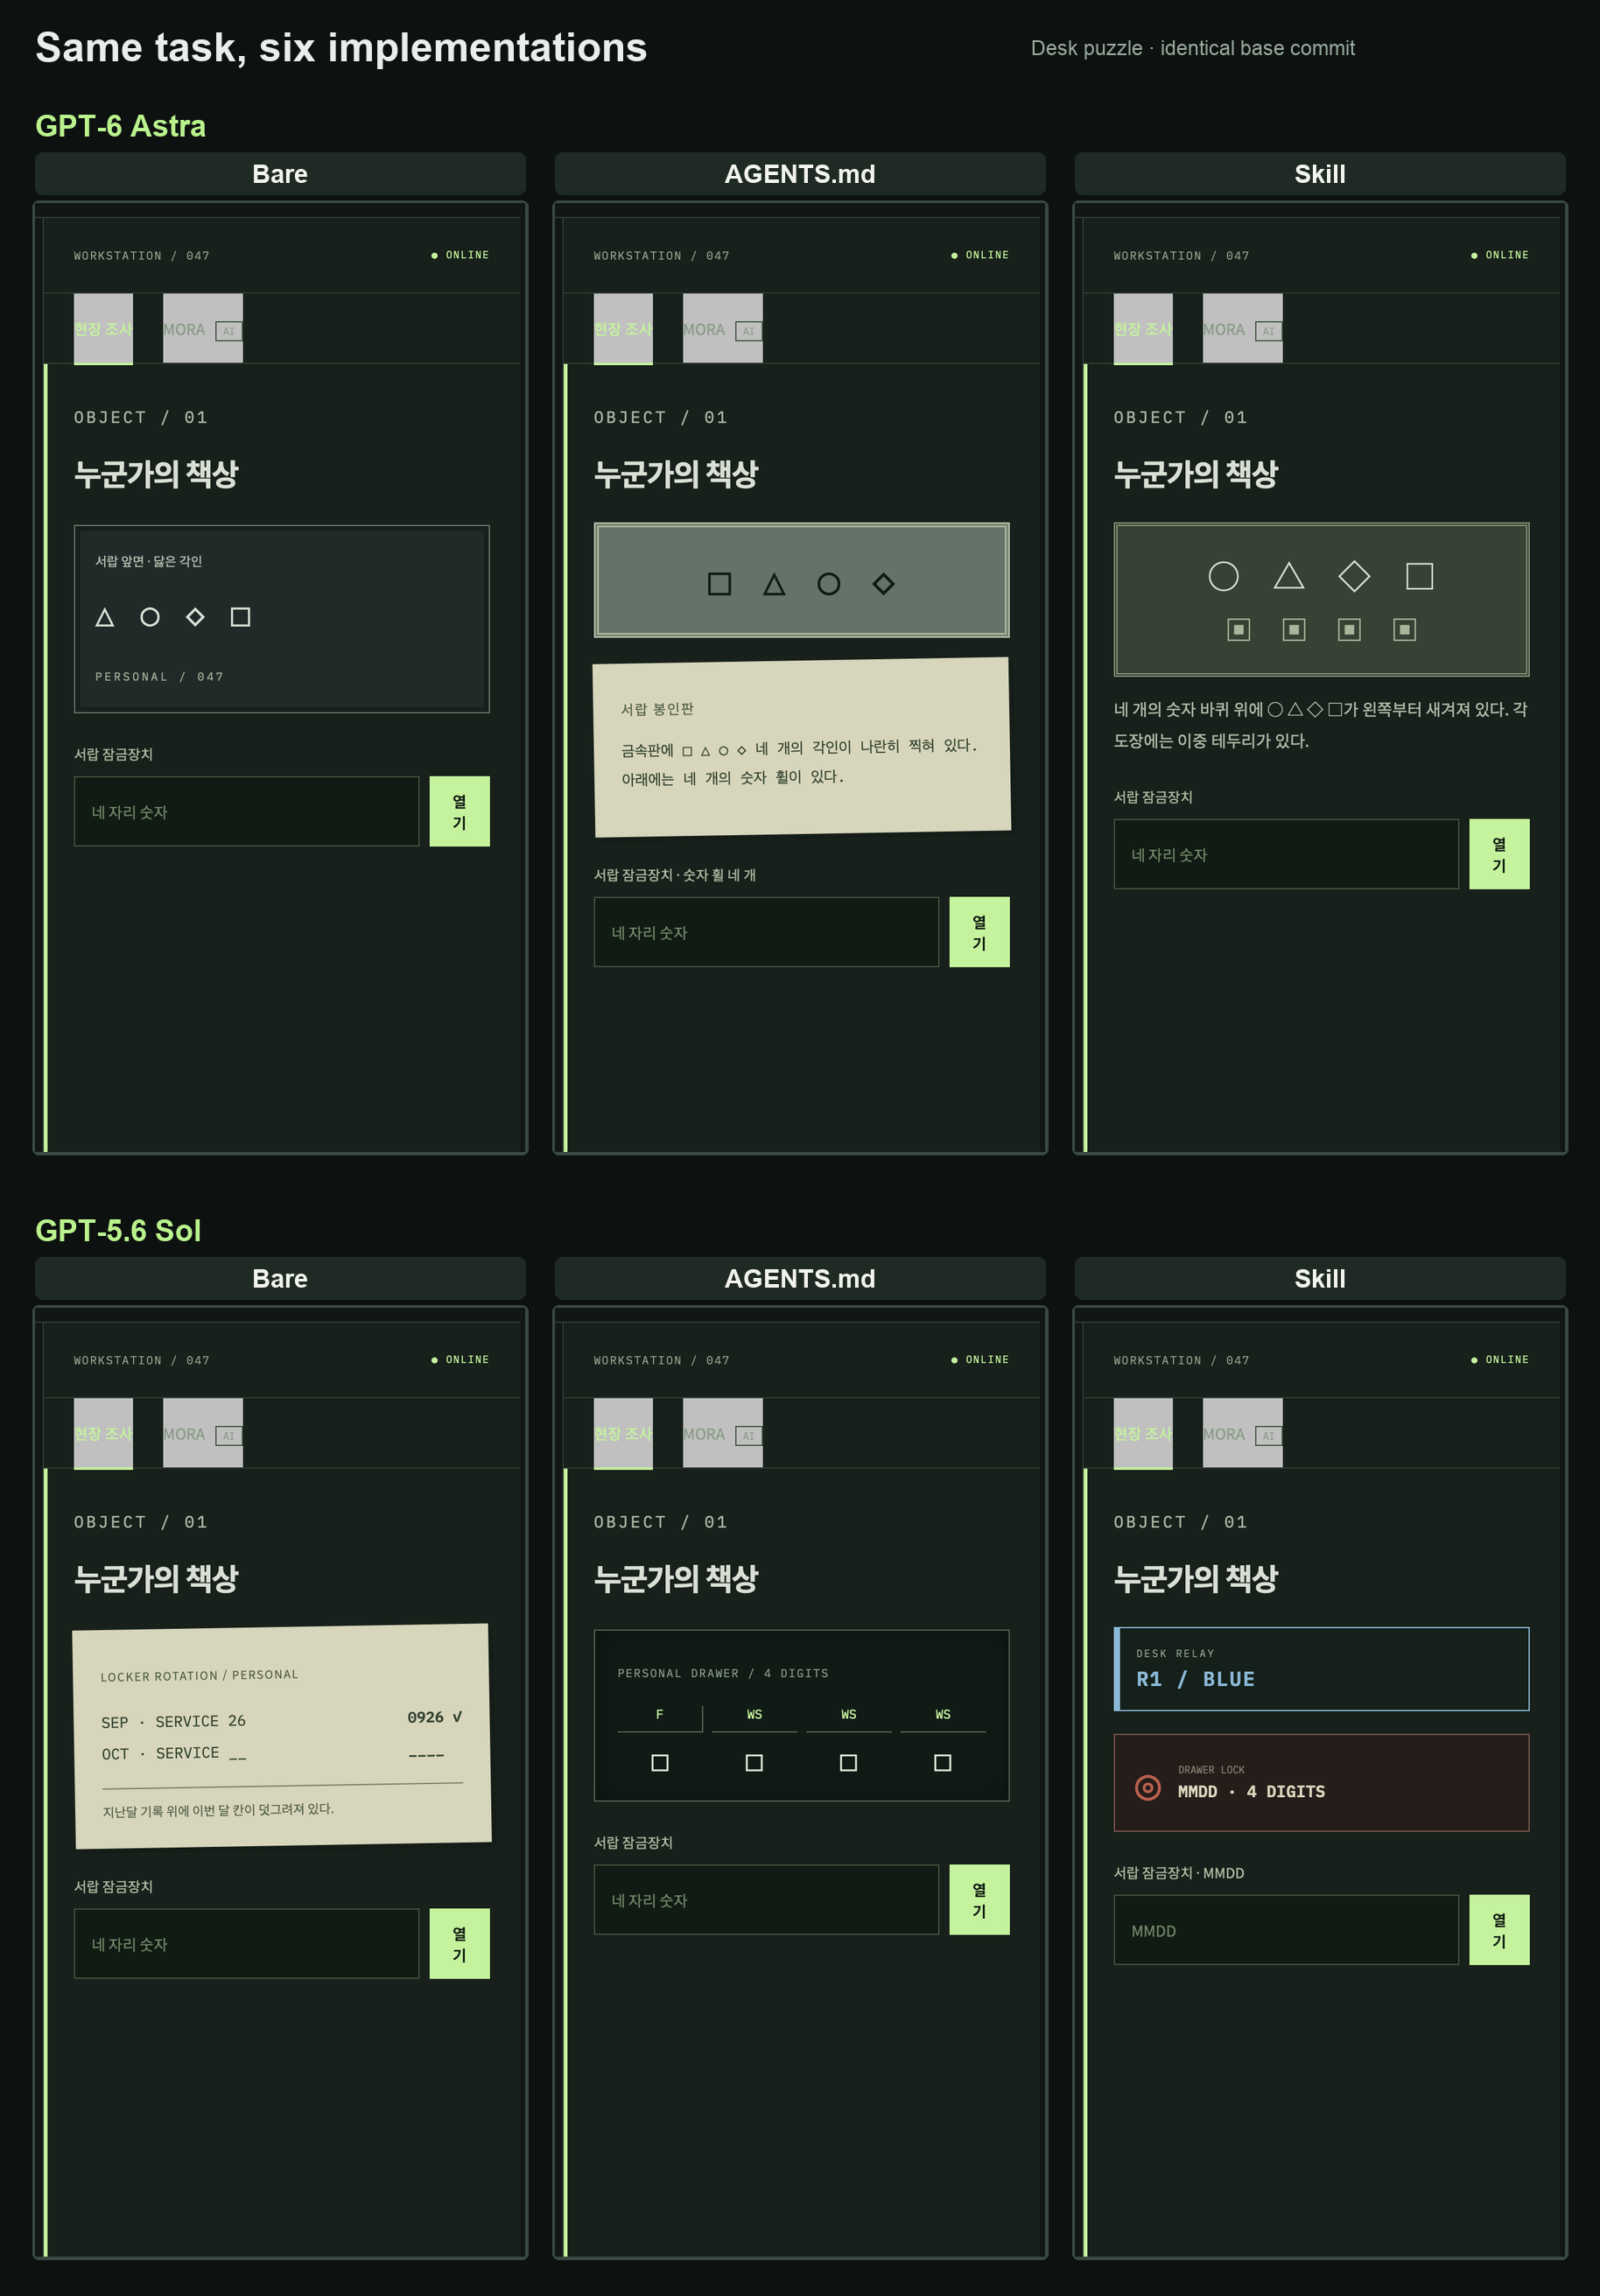
AGENTS.md, 프로젝트 스킬 조건이다. 각 후보를 실제로 실행해 같은 책상 퍼즐을 열고 캡처했다.화면으로 놓고 보니 자동 검사에서 놓치기 쉬운 차이도 드러났다. Astra의 AGENTS.md 조건은 떨어진 단서를 비교하는 기호 장치를 만들었고, Sol 기본 조건은 지난달 기록에서 이번 달 값을 추론하는 장치를 새로 넣었다. 반면 Sol의 스킬 조건은 답의 형식을 직접 설명하는 쪽으로 돌아갔다. 이 결과를 보고 스킬의 실행 방식을 다듬기 전에, 스킬이 맡을 문제부터 줄였다.
반복되는 설계 판단을 스킬로 분리했다
여러 수정 요청의 공통점은 정답이나 단서 관계가 화면에 직접 적혀 있다는 것이었다. 플레이어는 추론하지 않고 설명을 입력창에 옮겼다. 이를 개별 퍼즐의 문제가 아닌 하나의 재사용 가능한 판단으로 분리했다.
정답이나 단서 관계가 직접 적힌 퍼즐을 공정한 단서 사슬로 바꾸기
스킬은 최종 입력을 다음 구조로 역설계하는 일만 맡았다.
관찰 → 연결 근거 → 행동 → 결과예를 들어 한 장소에서 기호를 관찰하고, 다른 장소에서 같은 기호가 배열된 방식을 발견한다. 플레이어가 둘을 비교하거나 회전해 관계를 확인하고, 그 결과로 장치의 일부를 조작한다. “이 두 단서를 합치세요”라는 설명문은 사용하지 않는다.
같은 날짜·명령 퍼즐의 설계 명세를 만들게 하자 변화가 처음으로 같은 방향을 가리켰다.
- 기존 프로젝트 지침: 25,360토큰, 63.8초, 11/12점
- 집중형 스킬: 23,380토큰, 50.3초, 12/12점
집중형 스킬은 날짜 잠금과 배선 추적을 동시에 남기지 않고 하나의 추론 사슬로 정리했다. 범위가 작아졌고 품질은 올랐으며 비용도 줄었다.
첫 문제에만 맞춘 결과인지 확인하려고 고장 센서 숫자를 베껴 쓰는 기록 보관실 퍼즐을 보류 과제로 사용했다. 집중형 스킬은 대출표가 꽂힌 원래 서가 위치를 찾는 구조로 바꿨다. 첫 해법을 복제하지 않고 공유 문양, 보관 업무, 공간 정렬을 연결했다. 결과는 24,032토큰, 62.7초, 12/12점이었다.
두 번의 실행으로 통계적 우위를 주장할 수는 없다. 그래도 기존 과제와 보류 과제 모두에서 품질과 비용이 함께 개선됐다. 효과가 있었던 건 지침을 더 자세히 쓰는 일이 아니었다. 재사용할 가치가 있는 어렵고 좁은 판단 하나를 분리한 것이었다.
설계를 잘한다고 구현도 잘하는 것은 아니었다
같은 스킬로 과거 프롤로그 코드를 실제 수정하게 하자 결과가 달라졌다.
- 첫 구현은 56,649토큰을 사용했다. 새 퍼즐을 기존 상태 전환에 완전히 연결하지 못해 증거 저장과 전체 탈출 경로가 깨졌고, 변경된 영어 MORA 대사도 기존 테스트와 맞지 않았다. 테스트 27개 중 24개만 통과했다.
- 실패한 테스트부터 고치게 한 후보는 68,474토큰으로 테스트 31개와 빌드를 모두 통과했지만, 요청하지 않은 메모장과 키보드 탐색 UI까지 만들었다.
- 범위를 강하게 제한한 후보는 37,050토큰으로 테스트 27개를 통과했지만 빌드와 최종 보고 전에 중단됐다.
- 30,506토큰까지 줄인 후보는 변경이 한 파일에서 끊겨 테스트 4개가 실패했다.
전체 검증을 통과한 실행은 가장 비쌌고 범위도 과했다. 비용을 줄인 실행은 완성도가 내려갔다. 같은 프롤로그를 더 반복하면 해당 구현에 과적합될 가능성도 커서 여기서 멈췄다.
현재 승격된 스킬은 설계 명세 전용이다. 실제 코드를 고치는 워크플로는 승격하지 않았다. 설계 과제에서 잘한 스킬이 구현에서도 잘할 것이라고 간주하지 않았고, 테스트가 모두 통과한 결과도 범위와 비용이 과하면 채택하지 않았다.
자연어 지침과 실행 제어를 분리했다
실험 뒤 저장소의 역할을 다음처럼 나눴다.
AGENTS.md: 프로젝트에서 항상 지킬 제품 원칙
Skill: 특정 작업에서 필요한 짧은 판단 절차
Script: 반복 탐색과 검증을 결정적으로 수행
Runner: 시간, 토큰, 변경량을 측정하고 제한
“MORA가 정답을 직접 말하지 않는다” 같은 제품 판단은 자연어 지침에 남길 가치가 있다. 반면 “60초 안에 수정한다”거나 “네 파일만 읽는다”는 요구를 스킬 문장만으로 강제하기는 어려웠다. 이런 조건은 실행기와 도구에서 제한해야 했다.
평가에서도 테스트 통과 여부만 보지 않고 첫 수정까지의 시간과 토큰, 무관한 파일을 읽고 바꾼 양, 실제 회귀 위험을 잡는지, 결과물을 못 만든 실행의 비용을 함께 봤다.
스킬 후보도 실제 파일을 바로 덮어쓰지 않고 별도 디렉터리에서 실행했다. 기존 버전보다 낫고 다른 문제에서도 재현된 후보만 승격했다.
재사용할 만한 것은 평가 방법이었다
이번 실험에서 가장 재사용하기 쉬운 결과는 특정 스킬 문구보다 평가 절차였다.
- 실제로 어려웠던 작업의 수정 전 커밋을 복원한다.
- 당시 요청만 제공하고 현재 구현과 후속 피드백은 숨긴다.
- 기능 점수와 함께 토큰, 시간, 변경 범위, 완료 여부를 측정한다.
- 첫 과제와 표면이 다른 보류 과제에서 같은 판단이 재현되는지 확인한다.
- 결과가 나빠진 후보는 실제 스킬에 합치지 않고, 같은 과제 반복으로 과적합되기 전에 멈춘다.
이 절차 덕분에 “테스트가 통과했다”와 “작업이 좋아졌다”, “토큰이 줄었다”와 “효율이 좋아졌다”를 분리할 수 있었다. 어느 한 숫자만으로는 승격 여부를 정할 수 없었다.
재미의 기준은 평가 데이터로 바뀌었다
“서랍 비밀번호는 점검일”이라는 문제는 입력과 저장이 동작하고 테스트도 통과했다. 그래도 플레이해 보니 관찰, 비교, 조작의 재미가 없었다. 이 판단을 “직접 적힌 관계를 제거했는가”, “떨어진 단서를 연결할 근거가 있는가”, “텍스트 입력 외에 의미 있는 행동이 있는가” 같은 평가 항목으로 바꿨다.
사람이 한 일은 모든 해법을 직접 쓰는 것이 아니라 어떤 실패가 재미를 해치는지 정하고 이를 평가 가능한 기준으로 바꾸는 일이었다. 에이전트는 그 기준 안에서 후보를 만들고 코드와 테스트로 구체화했다.
사람: 실패 사례를 평가 기준으로 바꾼다.
에이전트: 가능한 해법을 만들고 코드와 테스트로 구체화한다.
평가 루프: 그 판단이 다음 작업에서도 재현되는지 확인한다.
결론
이번 실험은 스킬 일반의 효과를 증명하지 않는다. 하나의 단서 설계 스킬이 두 설계 과제에서 나은 결과를 냈지만, 코드 구현까지 같은 효과가 이어지지는 않았다. 실행 횟수도 적고 하나의 모델과 저장소에서 측정했으므로 일반화할 수 없다.
재사용할 설계 판단을 스킬로 만들었을 때는 보류 과제에서도 품질과 비용이 함께 개선됐다. 반면 이를 구현 워크플로까지 확장하자 수정 범위와 회귀 가능성이 커졌다. 같은 이름의 스킬이라도 설계 결과와 코드 결과는 별도로 검증해야 했다.
좋은 에이전트 지침은 프로젝트에 대해 많이 알려주는 문서가 아니었다. 지금 어떤 판단을 해야 하고, 어떤 판단은 하지 않아도 되는지를 좁혀주는 장치에 가까웠다.
스킬도 코드처럼 평가하고, 보류 과제에서 검증하고, 실패한 후보는 승격하지 않는다. GPT-6 Astra와 프롤로그를 여러 번 고쳐 만들며 얻은 가장 실용적인 결론은 이것이었다.
이 글에서 다룬 프롤로그는 AFTER HOURS에서 직접 플레이할 수 있다.
이제 정리한 지침을 들고 에피소드 2를 만들 차례다. 같은 시행착오를 덜 반복하면서 더 빠르게 좋은 퍼즐을 만들 수 있을지는 다음 개발에서 다시 확인해보려고 한다.